
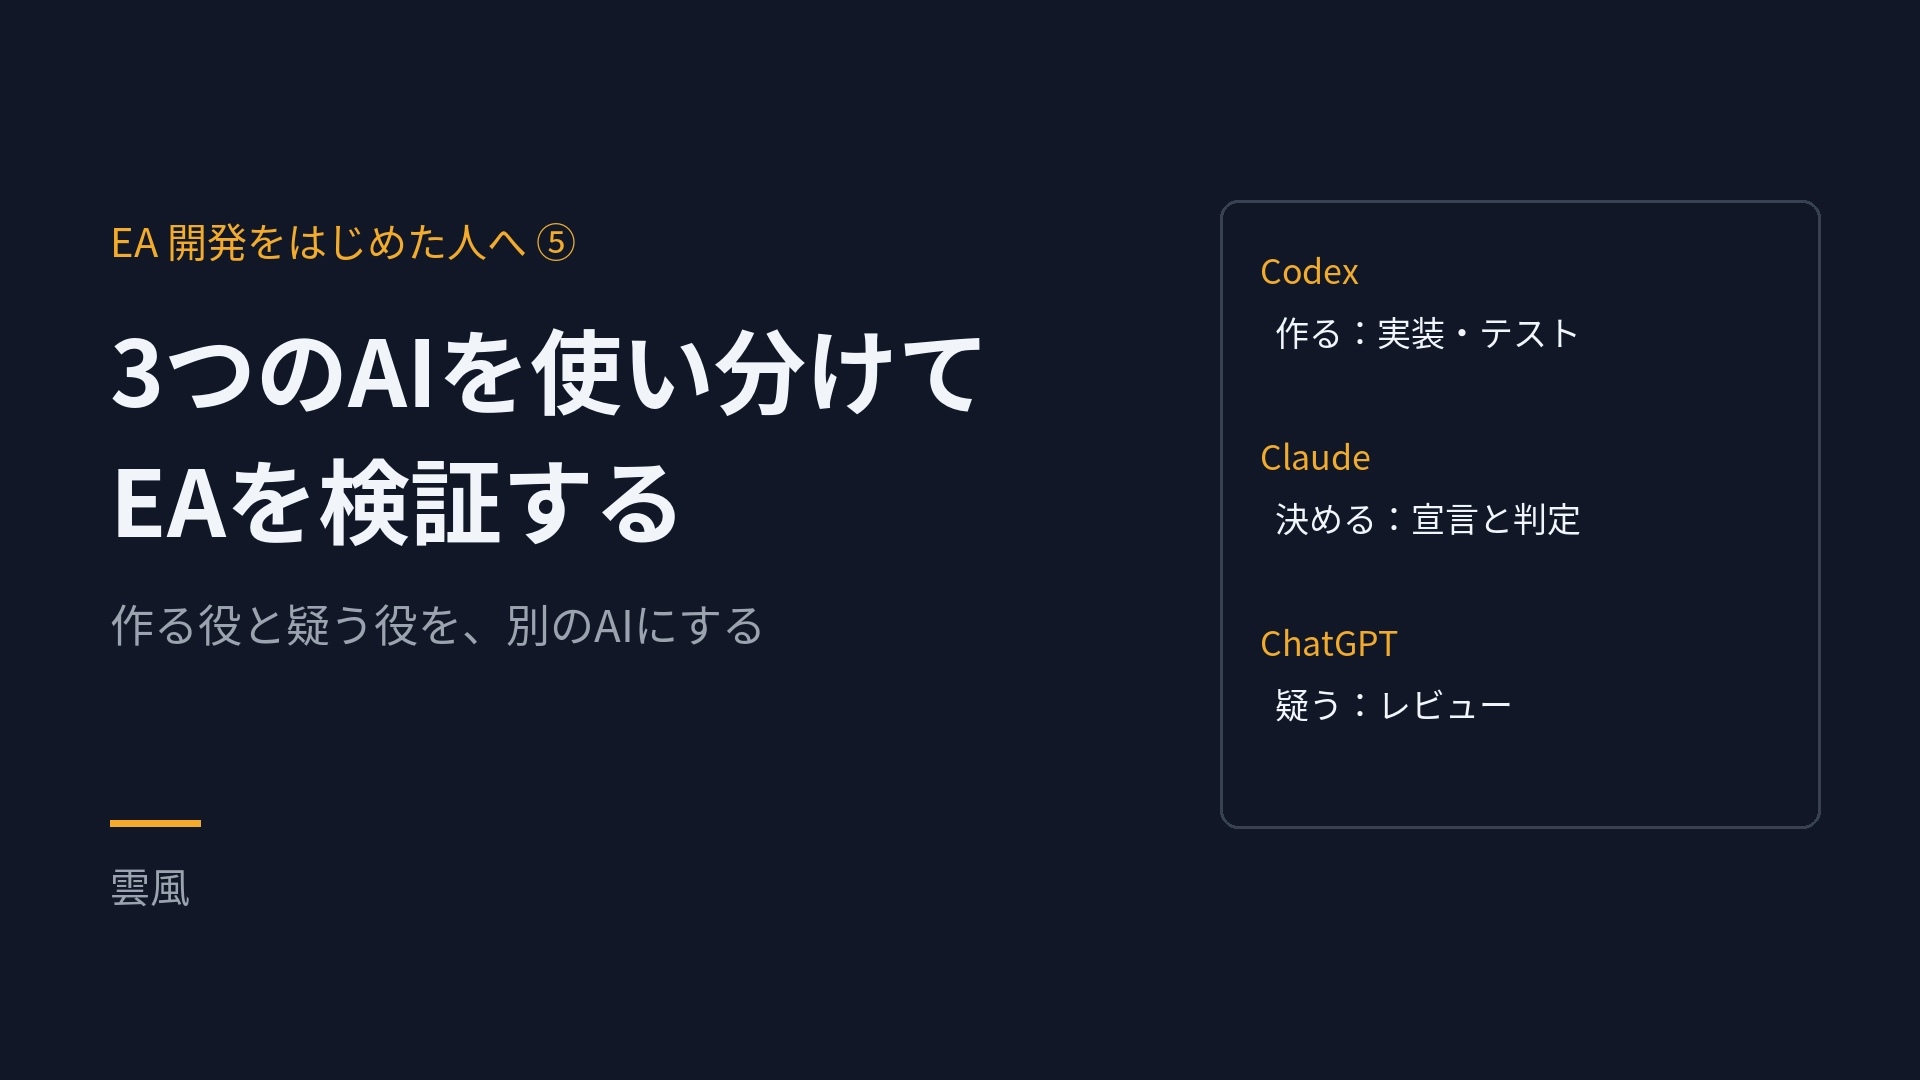
3つのAIを使い分けてEAを検証する――作る役と疑う役を、別のAIにする
はじめに:1つのAIに全部任せると、誰も疑わなくなる
この連載では、AIでEAを作るときの落とし穴を書いてきました。「バックテストを良くして」と頼むと過剰最適化になる。「魅力的に書いて」と頼むと商品概要が盛られる。どちらも根は同じで、作る役と疑う役が同じだと、誰も疑わなくなるということです。
AIは頼まれたことを忠実にやります。作った本人(あなたと、その会話のAI)は、自分の結果を良く見たい立場にいます。だから、同じ会話の中で「本当に大丈夫?」と聞いても、答えは甘くなりがちです。
私はいま、ChatGPT・Claude・Codexの3つのAIに役割を分けて、EAの開発と検証を進めています。今回はその分担と、互いに見直させる仕組み、そしてAIが1つしかなくても真似できるやり方を書きます。
3つのAIの役割分担
分け方の考え方は単純です。「作る役」と「確かめる役」を、別のAIにする。そして、それぞれの担当が重ならないようにすることです。
| AI | 主な担当 | 他のAIに対して答えること |
|---|---|---|
| Codex | コードを書く。バックテストやEAの実装、ビルド、テスト | コードが何をしているか、テストが通っているか |
| Claude | 検証の設計と結果の読み解き。事前宣言や採用条件を文書にし、結果をその条件で判定する | 今どの条件で判定しているか、運用の状況 |
| ChatGPT | Claudeの設計と結果のレビュー。あわせて、成果の二次利用や別の事業への展開を考える壁打ち役 | 設計や判定に見落としがないか |
大事なのは、どのAIも自分の担当以外を「ついでに」やらないことです。コードを書いたAIに、そのコードが出した成績の合否まで判定させると、「自分の作品を良く見たい」立場に戻ってしまいます。
もう一つ、私自身を毎回の説明役にしないことも決めています。AI同士が互いに状況を聞き合えるように、どのAIが何に答えるかを先に決めています。私が間に入って要約すると、そこでも「良く見たい」が混ざるからです。
互いに見直させる仕組み:順番を固定する
役割を分けるだけでは足りません。どの順番で、誰が何を決めるかも固定しています。
- 結果を見る前に、探し方と採用条件を文書にする。何を何通り試すか、どの条件を満たしたら採用するか、何をやってはいけないか。私はこれを「事前宣言」と呼んでいます
- 作る役は、宣言どおりに実装して回すだけ。結果の良し悪しは言わせません。宣言にない「改善」をしたくなったら、手を止めて報告させます
- 判定は、宣言の条件だけで機械的に行う。「惜しいから」「この条件は厳しすぎた」で通さない
- 通ったものを、別の役に「偶然だとしたら、なぜか」と疑わせる。合格を喜ぶ役ではなく、落とす理由を探す役です
この順番で大事なのは、1が先であることです。結果を見てから条件を決めると、どんな結果にも合う条件を、AIはいくらでも用意してくれます。
実際に、宣言を守ったために試す数を減らしたこともあります。途中で損切りと利確の幅も試したくなり、その版を書きかけました。しかし数えると検定が516通りになり、宣言で決めた上限の288通りを超えたので、固定に戻しました。
実例:合格5本、正体は1つ
この進め方で、主要な通貨ペア2つ、8つの戦略の型を、合計129通り検定したことがあります。採用条件は7つで、最後の1つは「隣の時間足か、もう一方の通貨ペアでも成り立つこと」でした。詳しい経緯は「合格5本、正体は1つ」の記事に書きました。
結果、条件をすべて通ったのは5本。一見すると「5つも勝てるルールが見つかった」です。ここで作る役のまま結果を読むと、5本を並べて運用したくなります。
ところが疑う役として中身を確かめると、5本はすべて「同じ通貨ペアの、同じ市場が開く時間帯に、直前の方向へ順張りする」ものでした。型の名前が違うだけで、実装はほぼ同じです。独立した発見は、実質1つでした。
さらに、後から平均の95%信頼区間を出すと、5本とも「ゼロと区別できない」でした。理由は取引数の少なさで、採用した1本で決着するには約118件が必要ですが、その時点では72件でした。
もし1つのAIに「この5本はどう?」と聞いていたら、たぶん「5つの有望なルールを分散して運用しましょう」と返ってきたと思います。分散しているつもりで、実際は同じ一つに5倍賭けていたことになります。
私の分担でいえば、この「合格したものの中身を確かめる」作業こそ、ChatGPTにレビューを頼んでいる役目です。結果を出したClaudeとは別の目で、「本当に5つあるのか」を問い直してもらいます。
すぐ真似できるやり方:AIが1つでもできること
3つのAIを契約しなくても、同じことはできます。大事なのはAIの数ではなく、「作る会話」と「疑う会話」を分けることです。
- 作る前に、宣言を書く。試す範囲、試す数の上限、採用条件をメモにして保存します。第3回のチェックリストをそのまま採用条件に使えます
- 作る会話では、宣言を渡して「この範囲でだけ実装して」と頼む。結果の評価は頼みません
- 疑う会話を、新しく開く。前の会話の流れを引きずらないように、宣言と結果だけを渡して、次のように頼みます
あなたは、このEAを採用しない理由を探す役です。
添付の事前宣言とバックテスト結果を読み、
・宣言の条件を満たしていない点
・宣言にないことをしている点(条件の後付け、試した数の超過など)
・合格したもの同士が、実は同じ一つの現象を拾っていないか
・偶然の好成績だとしたら、どう説明できるか
を挙げてください。良い点は書かなくて構いません。
「良い点は書かなくて構いません」が大事です。これがないと、AIは気を使って良い点と悪い点を半分ずつ並べ、結論がぼやけます。
- 最後に決めるのは自分。疑う会話が出した理由に答えられなければ、そのEAはまだ採用しません
まとめ
- 作る役と疑う役が同じだと、誰も疑わなくなる。AIを分けるのは、その役を分けるため
- 順番は、宣言→実装→条件で判定→別の役が疑う。結果を見てから条件を決めない
- 「合格5本」は、疑う役が見ると「正体は1つ」だった
- AIが1つでも、作る会話と疑う会話を分ければ同じことができる
ここまでの5回で、AIでEAを作り、確かめ、出品し、紹介するまでの一通りを書きました。どの回も、言っていることは同じです。自分の結果を、自分とは別の目で疑うこと。
同じ確認をTradingViewのストラテジーに当てた話は、続きの第6回「TradingViewのストラテジー結果を、初期設定のまま読まない」に書きました。
おまけ:「疑う役」を機械に任せるには
疑う役をAIではなく、基準が固定された道具に任せる方法もあります。自作の点検ツール「EA頑健性チェック」は、まさにそのために作りました。判定の基準は固定で、結果を見てから緩めることはできません。AIのように気を使うこともありません。
自分では疑いにくい、という方向けに、点検を受けられるサービスも用意しています。EAバックテストの頑健性を第三者が点検します ¥14,800(Skijan)。MT5のレポート最大3本をお預かりし、所見書(PDF)にまとめて3営業日以内にお返しします。判定の基準は固定で、結果が良くなかった場合に結果を変えることはできません。
※本記事は筆者自身の進め方を紹介するもので、特定の銘柄・手法・EAの売買や、特定のAIサービスの利用を勧めるものではありません。過去の検証結果は将来の成績を保証するものではありません。
