
なぜAI機械学習で市場予測が可能なのか?
- なぜAIでFX相場を予測できるのか
- 予測できると言える3つの根拠
- ディープラーニングが向いている理由
- それでも当たらない4つの理由
- 実務で成果が出ている領域
- 時間軸ごとの予測可能性
- 第1部のまとめ
- 市場予測におけるAI機械学習の可能性とONNXで広がる未来
- FX×AI機械学習の現状と限界
- なぜ今「ONNX」なのか?
- ONNXが切り拓くシステムトレードの未来
- 導入における課題と成功へのアプローチ
- AIトレードの罠:過学習と過剰最適化
- 定義と発生メカニズムの違い
- 実践的な対応策
- まとめ:過去は未来を完璧には予測しない
第1部
なぜAIでFX相場を予測できるのか
機械学習が捉えているのは「未来の価格」ではなく、価格に残るわずかな統計的偏りです。その偏りは確かに存在しますが、多くの場合は取引コストに吸収されてしまう大きさしかありません。
- 為替は完全なランダムウォークではなく、短時間ほど統計的な偏りが残る。
- ディープラーニングは、その偏りを非線形かつ多変量で捉えられる。
- ただし優位性は小さく、コスト・過学習・市場環境の変化で簡単に消える。
1. 予測できると言える3つの根拠
市場は完全なランダムではない
効率的市場仮説は良い近似ですが、厳密な真実ではありません。大口注文は分割して執行され、値動きに追従する売買が発生し、経済指標が価格に織り込まれるまでには遅延があります。こうした市場のミクロ構造が、短い時間軸に微弱な規則性を残します。
変数の効き方が非線形である
金利差、VIX指数、需給、地政学リスクは、価格に対して素直な比例関係では効きません。あるしきい値を超えて初めて効く、他の変数と組み合わさって初めて効く、といった条件付きの効き方をします。線形回帰が取り逃がすこの構造を、多層ネットワークは表現できます。
変動の大きさは持続する
価格が上がるか下がるかは読みにくい一方で、変動の大きさには持続性があります(ボラティリティ・クラスタリング)。GARCH系のモデルが長年扱ってきたこの性質は、機械学習でも安定して再現できる、数少ない信頼できる予測対象です。
2. ディープラーニングが向いている理由
従来のニューラルネットワークは、長い系列を扱うと過去の情報が勾配とともに失われ、数十本前のローソク足を参照できませんでした。これを解決したのが次の2つの構造です。
LSTM
忘却ゲート・入力ゲート・出力ゲートという3つの弁を学習し、「残す情報」と「捨てる情報」を自分で決めます。セルステートが長期記憶として働くため、100ステップ以上前の状態も保持できます。
Transformer
自己注意機構によって、どの時点の値がいま効いているのかを重みとして学習します。複数の時間スケール(数分の動きと数日のトレンド)を同時に見られる点が、為替のようなマルチスケールな系列と相性の良いところです。
両者に共通する利点は、人が特徴量を設計しなくても、生の系列から関係を取り出せることです。裏を返せば、意味のない関係まで拾ってしまうということでもあります。
3. それでも当たらない4つの理由
得られる優位が、そもそも小さい
よく作り込まれたモデルでも、方向の的中率は52〜55%程度に落ち着きます。コイン投げの50%に対する上乗せは数ポイントしかありません。これは「当たる」という感覚とはかけ離れた数字です。
取引コストが優位を食う
数ポイントの優位は、スプレッドとスリッページで容易に相殺されます。的中率が理論上プラスでも、コスト控除後の期待値はほぼ五分になることが珍しくありません。
| 項目 | 目安 |
|---|---|
| 検証時の方向的中率 | 55% |
| スプレッド(主要通貨ペア) | 0.1〜0.2 pips |
| スリッページ(変動時) | 1〜3 pips |
| コスト控除後の実効的な優位 | ほぼ消失 |
過学習が起きやすい
金融時系列はノイズが支配的なため、モデルは容易に「過去のノイズの形」を覚えてしまいます。訓練データで75%、検証データで52%、実運用で48%という劣化は典型的な経過です。ハイパーパラメータの過剰な調整と、特徴量作成時のデータリークが主な原因です。具体的な発生メカニズムと対策は第3部で詳しく扱います。
市場が定常でない
為替のトレンドは、金融政策・危機・インフレ局面などによって数年単位で性質が変わります。モデルが最適化した環境そのものが消えるため、精度の劣化は「バグ」ではなく前提として設計に織り込む必要があります。
4. 実務で成果が出ている領域
方向を当てにいく用途は分が悪い一方で、次の3つは比較的うまくいっている領域です。
超短期の統計的優位
分から数時間の時間軸では、テクニカルな需給要因が支配的になります。小さな優位を取引回数で拡大する発想で、低レイテンシと低コストが前提条件になります。この「低レイテンシ」の要件が、第2部で扱うONNXによるネイティブ実行の動機に直結します。
相場レジームの判定
「上がるか下がるか」ではなく「いまはトレンドか、レンジか、混乱か」を分類する使い方です。分類結果に応じて戦略を切り替えることで、順張りと逆張りの取り違えを減らせます。
異常・ボラティリティの検知
急変の予兆を捉えてポジションを落とす、リスク管理のための用途です。利益を取りにいく機能ではありませんが、最大ドローダウンの抑制に直接効きます。
5. 時間軸ごとの予測可能性
| 分〜時間 |
|
有意だがコスト次第 |
| 日〜週 |
|
灰色 |
| 月〜年 |
|
ほぼ不可能 |
| ボラティリティ |
|
比較的よく当たる |
| 暴落のタイミング |
|
不可能 |
バーの長さは相対的な手応えを表したもので、厳密な数値ではありません。方向の予測は時間軸が伸びるほど難しくなり、変動の大きさの予測は逆に安定します。
6. 第1部のまとめ
AIは相場を当てる道具ではなく、確率をわずかに傾ける道具です。傾き自体は本物ですが小さく、放っておけば市場の変化とともに劣化します。継続的な再学習と、優位性が失われたことを検知する仕組みまで含めて、はじめて運用と呼べる形になります。
実際に試す場合、最低限これだけは決めてから始めることをおすすめします。
- デモ環境で最低1か月、実際のスプレッドとスリッページを含めて検証する
- シャープレシオ1.0未満、または最大ドローダウン15%超で停止する基準を先に決める
- 月次で的中率を測り、検証時の理論値との乖離を追う
- 2か月連続で成績が悪化したら、調整ではなく作り直す
- 単一モデルに依存せず、性質の異なる戦略を併用する
「わずかな優位を、コストに食われる前に、劣化を検知しながら回し続ける」。これがAIトレードの実像です。続く第2部ではその優位を実行環境で失わないための技術(ONNX)を、第3部では優位そのものが幻だった場合の見抜き方(過学習対策)を扱います。
第2部
市場予測におけるAI機械学習の可能性とONNXで広がる未来
金融市場の複雑な価格変動を予測するため、システムトレードの世界ではAI(人工知能)や機械学習、ディープラーニングの導入が急速に進んでいます。しかし、高度な予測モデルを開発しても、それを実際の取引プラットフォーム上で遅延なく稼働させることには大きな技術的ハードルがありました。
この「開発環境」と「実行環境」の壁を打ち破り、次世代の自動売買システム(EAやcBot)の可能性を広げているのが ONNX(Open Neural Network Exchange) です。
1. FX×AI機械学習の現状と限界
ディープラーニングを筆頭とする機械学習モデルは、過去の膨大な時系列データから人間には認識困難な非線形のパターンを抽出することに長けています。
- 時系列予測(RNN/LSTMなど): 過去の価格推移やボラティリティから、次のローソク足の方向を確率的に予測。
- 強化学習(RL): トレード環境の中でエージェントに「利益の最大化とドローダウンの最小化」という報酬を与え、最適な売買ルールの学習を反復。
- 特徴量エンジニアリング: 単純な価格データだけでなく、複数のインジケーター(移動平均やストキャスティクス等)、オーダーブック情報、マクロ経済指標などを多次元的に入力。
従来の課題:実装の壁
Python(TensorFlowやPyTorch)で優れた予測モデルを構築しても、MT4/MT5やcTraderといったプラットフォームにはPythonを直接実行する機能が標準搭載されていません。そのため、Web APIやソケット通信(ZeroMQなど)を介してPythonスクリプトと取引プラットフォームを連携させる手法が主流でしたが、
通信レイテンシ(遅延)の発生
や、運用環境の構築・保守の複雑さが実運用における大きな障壁となっていました。
第1部で見たとおり、AIが得られる優位はもともと数ポイントしかありません。通信の遅延で約定価格が数pipsずれるだけで、その優位は消えてしまいます。実行環境の問題は、モデルの精度と同じ重みを持つ課題です。
2. なぜ今「ONNX」なのか?
ONNXは、異なる機械学習フレームワーク間でモデルを相互運用するためのオープンフォーマットです。AIモデルの「共通言語」として機能します。
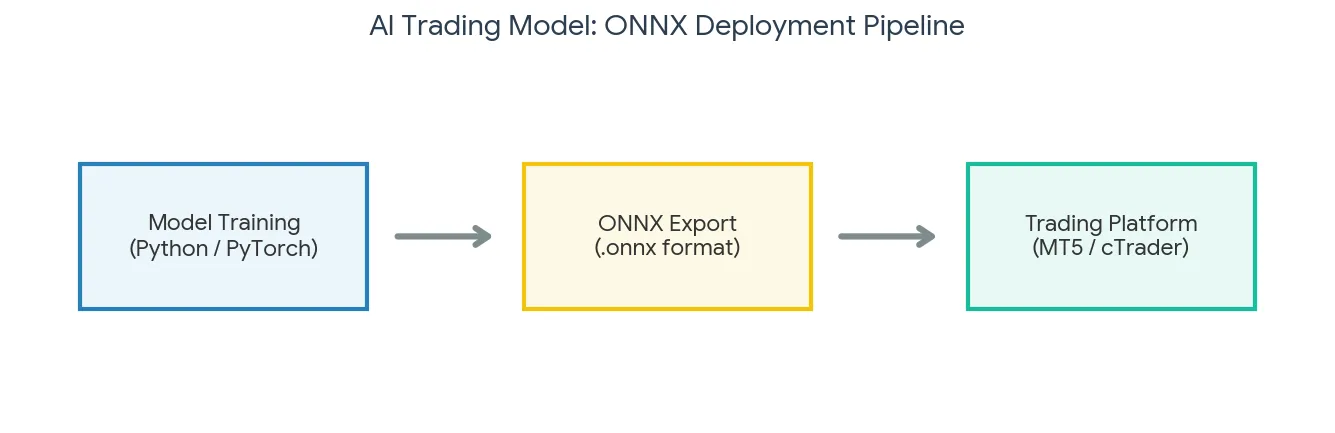
ONNXを活用することで、開発者は使い慣れたPython環境でモデルを訓練し、完成したモデルを
.onnx
ファイルとしてエクスポートするだけで済みます。このファイルは自己完結型の予測エンジンとして機能するため、Python環境が存在しない別の言語やプラットフォーム上でも、モデル構造と重みデータをそのまま再現して推論(予測)を行うことが可能になります。
3. ONNXが切り拓くシステムトレードの未来
ONNXの最大の恩恵は、 取引プラットフォームでのネイティブ実行 が可能になる点です。近年、MQL5(MT5)やC#(cTrader)などの主要な開発環境において、ONNXモデルを直接読み込み、実行する機能のサポートが強化されています。
| 比較項目 | 従来の通信ベース (API/ZeroMQ) | ONNXベースのネイティブ実行 |
|---|---|---|
| 実行速度(レイテンシ) | 通信オーバーヘッドによる遅延あり | プラットフォーム内で完結するため極めて高速 |
| 環境構築 | Python環境やサーバー設定が別途必要 |
.onnx
ファイルをプラットフォームに組み込むのみ
|
| 配布・販売の容易さ | ユーザー側にも複雑な設定を要求する | 単一のEA/cBotファイルとしてパッケージ化可能 |
| バックテスト | プラットフォーム単体での精緻なテストが困難 | ストラテジーテスター等で過去データを用いた検証が容易 |
ロジック(知能)の部分を最新のAIフレームワークで担い、決済やポジション管理などの実務(手足)の部分を堅牢な取引プラットフォーム(MT5やcTrader)に任せるという、完全な分業と統合が実現します。
4. 導入における課題と成功へのアプローチ
技術的なハードルは下がりつつありますが、AIを利益に直結させるには特有の課題への対処が必要です。
- 過学習(オーバーフィッティング)の回避: 過去のチャートに完全にフィットしたモデルは、未知の相場(フォワードテスト)で機能しません。学習データの厳密な分割と、ノイズの多いFXデータに対する堅牢な正則化手法が求められます。
- 市場のレジームシフト(環境変化): 相場のボラティリティやトレンドの性質は突発的に変化します。モデルが現在の市場環境に適応できているかを監視し、定期的に再学習(リトレーニング)を行う仕組みが必要です。
- ハイブリッド運用: すべての判断をAIのブラックボックスに委ねるのではなく、移動平均やストキャスティクスのクロスといった実績のあるテクニカルルールや、厳格な資金管理ロジック(SL/TPの固定)とAIの予測スコアを組み合わせる「半自動化(ハイブリッド)」アプローチが、実運用におけるリスク低減に有効です。
第3部
AIトレードの罠:過学習(オーバーフィッティング)と過剰最適化(カーブフィッティング)の違いと対応策
FXのシステムトレードやAI開発において、最も頻繁に遭遇し、かつ最も致命的な落とし穴となるのが「過去のデータに合わせすぎる」という問題です。
AI・機械学習の文脈では 過学習(オーバーフィッティング) と呼ばれ、従来のテクニカル指標を用いたEA開発の文脈では 過剰最適化(カーブフィッティング) と呼ばれます。これらは本質的に同じ「未知の相場への適応力欠如」という問題を指しますが、発生するメカニズムや対応策には違いがあります。
1. 定義と発生メカニズムの違い
過剰最適化(カーブフィッティング)
- 文脈: 従来のEA(エキスパートアドバイザー)やルールベースのシステムトレード開発。
- 原因: 開発者がインジケーターのパラメーター(移動平均の期間、ストキャスティクスの閾値など)を、過去の特定の期間において 最も利益が出るように手動またはオプティマイザーで調整しすぎる こと。
- 症状: バックテストでは綺麗な右肩上がりの資産曲線を描くが、実運用(フォワード)に移行した途端にドローダウンを引き起こす。過去の「ノイズ(偶然の値動き)」に対してルールを完全に適合させてしまった状態。
過学習(オーバーフィッティング)
- 文脈: 機械学習やディープラーニングを用いた予測モデルの開発。
- 原因: モデルの表現力(ネットワークの深さやパラメータ数)が高すぎるため、訓練データの中に含まれる 一般的なパターンだけでなく、特有のノイズや外れ値まで丸暗記(記憶)してしまう こと。
- 症状: 訓練データ(Training Data)に対する予測精度は99%などに達するが、検証データ(Validation Data)やテストデータ(Test Data)に対する精度が著しく低下する。
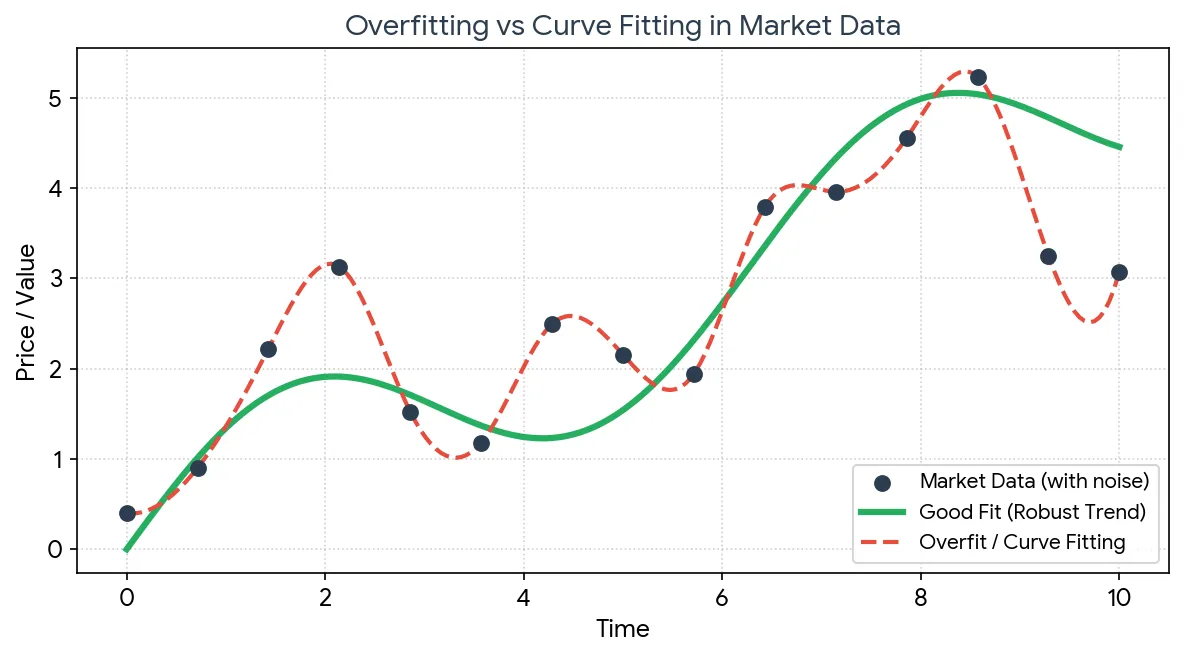
どちらも「過去の正解に固執しすぎて、未来への応用力を失っている状態」です。上の図の赤い点線のように、ノイズまで完璧になぞってしまっている状態が典型的な過学習/カーブフィッティングです。
2. 実践的な対応策
それぞれの問題に対する防御策は、開発のアプローチに合わせて異なります。
EA開発におけるカーブフィッティングの防ぎ方
- ウォークフォワード分析 (Walk-Forward Analysis): データを複数の期間に分割し、「最適化期間」で見つけたパラメータを、その直後の「検証期間」でテストするプロセスを繰り返します。これにより、パラメータの堅牢性(ロバスト性)を確認します。
- パラメータの「平原」を探す: 利益が最大になるピンポイントの数値(例:移動平均21)を選ぶのではなく、周辺の数値(例:19〜23)でも安定して利益が出る パラメータの「平原(Plateau)」 を選ぶべきです。鋭い「山(Peak)」は偶然の産物である可能性が高いです。
- 自由度(ルールの数)を減らす: 条件(インジケーターフィルターなど)を追加すればするほど、過去データには簡単にフィットします。しかし、シンプルなルールのほうが未知の相場には強い傾向があります。
AI・機械学習における過学習の防ぎ方
- データ分割の厳格化 (Hold-out / Cross Validation): データセットを「訓練(Train)」「検証(Validation)」「テスト(Test)」の3つに厳密に分けます。特に時系列データ(FX)の場合、未来のデータを訓練に混ぜてしまう「データリーク」を防ぐため、単純なランダム分割ではなく、時間軸に沿った分割(Time Series Cross Validation)が必須です。
- 正則化 (Regularization - L1/L2): モデルの重み(パラメータ)が大きくなりすぎることにペナルティを与える手法です。これにより、モデルが少数の特徴量(特定のインジケーターなど)に過度に依存するのを防ぎます。
- アーリーストッピング (Early Stopping): 学習プロセスにおいて、訓練データへの精度は上がり続けていても、検証データへの精度が低下し始めた(過学習が始まった)時点で学習を強制的にストップさせます。
- ドロップアウト (Dropout): ニューラルネットワークの学習時に、ランダムに一部のニューロンを無効化することで、特定の経路に依存しない汎化された特徴を学習させます。
3. まとめ:過去は未来を完璧には予測しない
EAのカーブフィッティングも、AIのオーバーフィッティングも、根底には 「金融市場はノイズに溢れた非定常な環境である」 という大前提を忘れた時に発生します。
いくら高度なAIモデル(ONNX)を構築し、MT5やcTraderでスムーズに稼働させたとしても、その中身が過学習状態であれば、システムは短期間で破綻します。「バックテストの美しさ」を競うのではなく、「未知の相場でのしぶとさ(堅牢性)」を追求することこそが、AIトレード開発の真の難所であり、醍醐味でもあります。
第1部で述べた「わずかな優位」は、第2部の実行環境で守り、第3部の検証手順で本物かどうかを確かめる。この3つが揃って初めて、AI機械学習によるFX相場予測は運用可能なシステムになります。
本記事は技術的な解説を目的としたものであり、投資助言ではありません。記載した数値は一般的な目安であり、通貨ペア・業者・時期によって大きく変動します。
1.販売中の商品はこちら
2.販売中の商品はこちら
