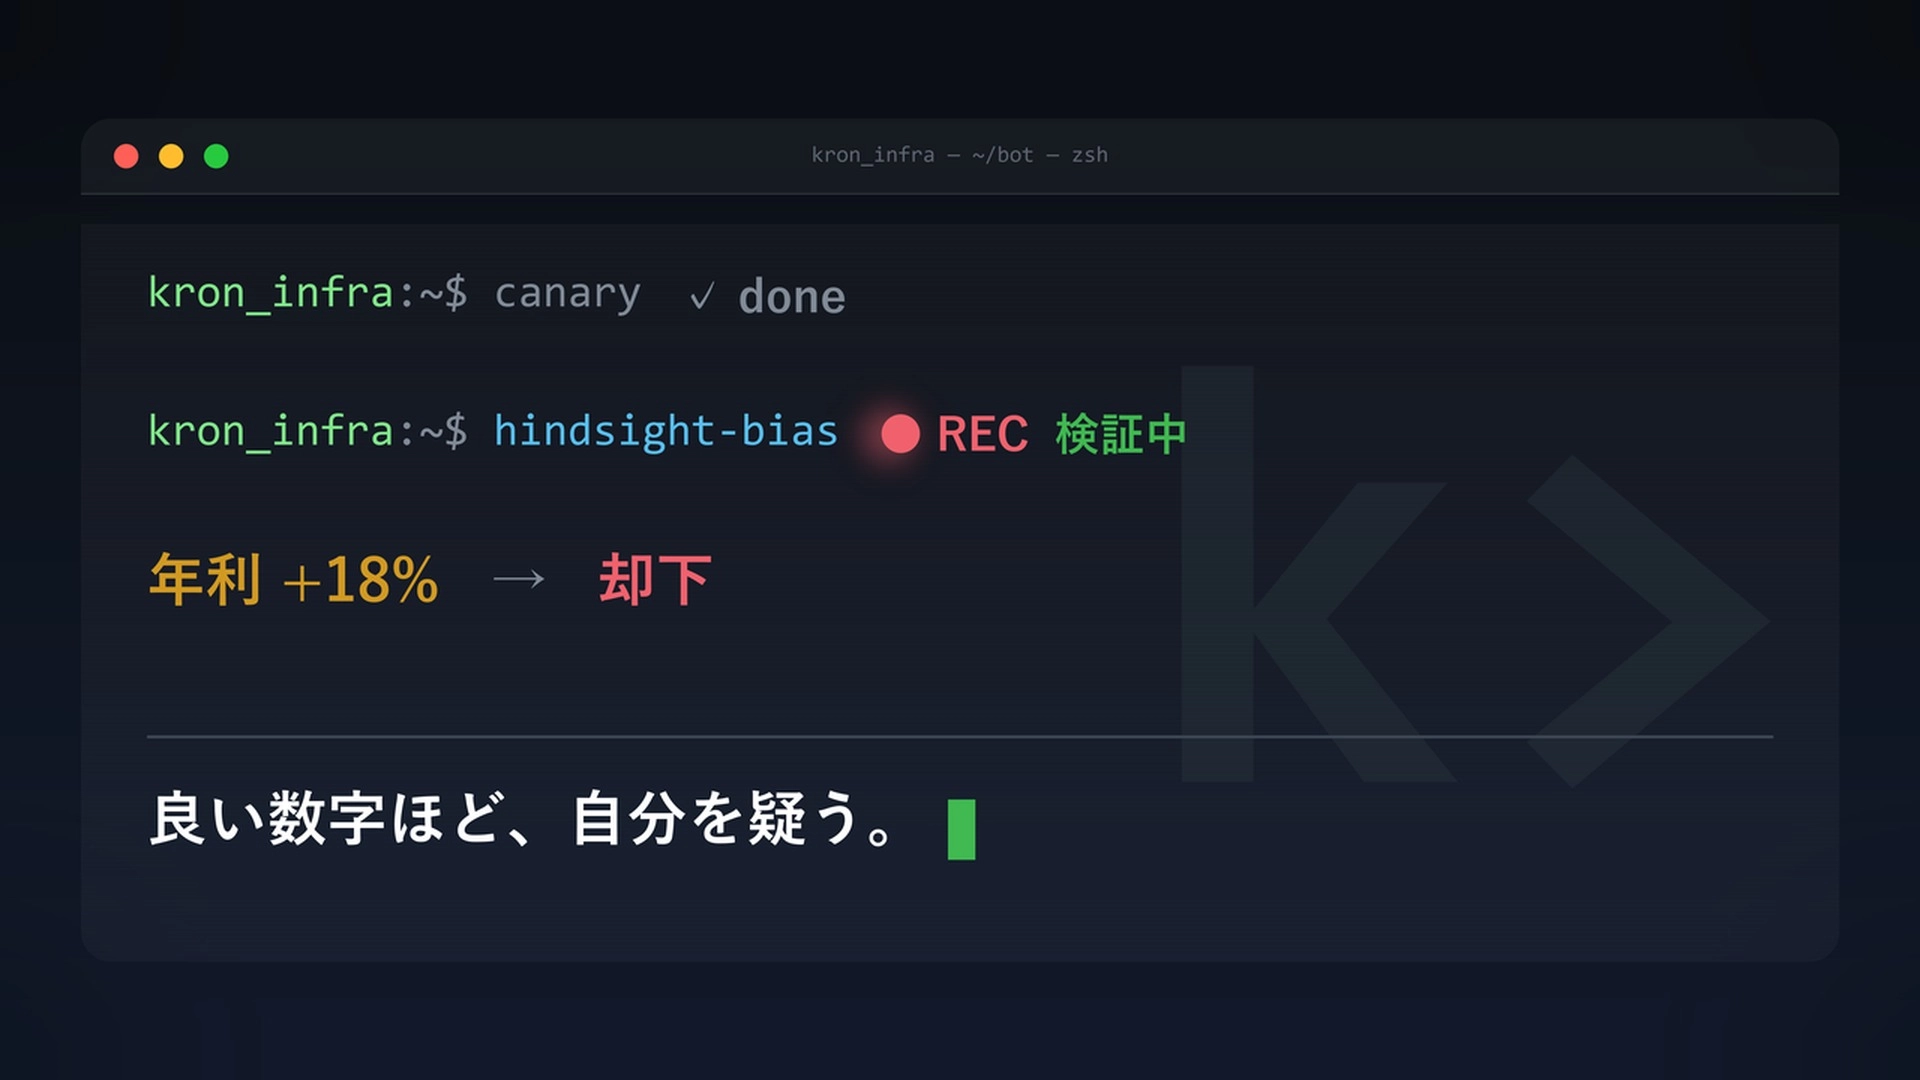
เมื่อเพิ่มจำนวนชื่อหลักทรัพย์ อัตราผลตอบแทนรายปีแทบจะ doubled แล้ว แต่นั่นเป็น "การโกงอนาคต"
สวัสดีครับ ผมครอน กำลังบริหารงานด้านวิศวกรโครงสร้างพื้นฐานอยู่ พร้อมกับ AI (Claude Code) ที่ผมสร้าง Bot สำหรับ swing ในหุ้นญี่ปุ่นด้วยตัวเอง ผมไม่ใช่มืออาชีพทั้งการเขียนโปรแกรมและการเทรดวันต่อวัน บันทึกการพัฒนานี้จะเขียนทีละนิด
เมื่อไม่นานมานี้ ผมได้ขยายรายการหุ้นที่เป็น “หุ้นที่เป็น candidates สำหรับการซื้อขายของ Bot” จาก 39 หลักเป็น 221 หลัก แล้วในการทดสอบย้อนหลัง 21 ปีที่ผ่านมา (คือทดสอบด้วยข้อมูลในอดีต) พบว่าผลตอบแทนต่อปีประมาณ +11% ขึ้นไปถึง +18% เกือบ 1.6 เท่าสัญลักษณ์ประสิทธิภาพความเสี่ยงยังดีขึ้นด้วย
“เอาเลย นี่คือของจริงใช่ไหม” ผมคิดขึ้นมา แต่ก่อนที่จะเขียนลงโน้ต ผมได้อ่านหมายเหตุที่ผมเขียนไว้เมื่อก่อนไปเพื่อนางสมัยก่อนที่เขียนไว้ในหมายเหตุแล้วพบว่าเป็นไปตามการคาดการณ์ในอนาคต ไม่ใช่ความสามารถจริง ๆ จึงถูกทิ้งไปในที่สุด
สิ่งที่บทความนี้บอกได้มีสองอย่าง
- เมื่อการทดสอบย้อนหลังได้ตัวเลขดี ๆ สิ่งที่ควรดูคือคุณค่าของความสามารถจริงหรือเป็นเพียงการคาดการณ์ในอนาคตโดยใช้เชิงตรวจสอบของตัวเอง
- เหตุใดเรื่องธรรมดาที่ว่า “ถ้候補ถูกเพิ่ม จะได้ผลลัพธ์ดีกว่า” จึงไม่ตรงกับกรณีนี้
สรุป: สิ่งที่ Bot ของผมทำ
โดยภาพรวม บอทของผม เปลี่ยนหุ้นในกลุ่มใหญ่ที่มีกำลังขึ้นในแต่ละเดือนหนึ่งครั้งเท่านั้น โดยอัตโนมัติจะเลือกหุ้นตัวใหญ่ระดับสูงที่มี momentum / ความเคลื่อนไว้ แล้วประเมินด้วยวิธีเชิงกลที่ดูจากการเคลื่อนไหวในอดีต เพื่อลดสัดส่วนหุ้นเมื่อสภาวะตลาดพังลง
รายการหุ้นที่เป็นหุ้น candidates สำหรับการเปลี่ยน (การสลับ) ผมเรียกว่ากลุ่มประชากร(ぼしゅうだん) ตอนนี้มี 39 หุ้น เพื่อให้ไม่เอียงไปทางอุตสาหกรรมใด มากนัก ผมคัดหุ้นใหญ่ที่อยู่ในรายการด้วยมือด้วยหุ้นที่มีคุณภาพ
ครั้งนี้ผมปรับเนื้อหาของประชากรนี้
ลองขยาย candidate list จาก 39 เป็น 221 หุ้น
สิ่งที่ทำก็เรียบง่ายแทนที่ประชากร 39 หุ้นด้วย 221 หุ้นที่มีสภาพคล่องจากการซื้อขายใน 1 หุ้นขึ้นไปวิธีวัด momentum จำนวนหุ้นที่ถือครอง สัญญาณความเสี่ยง และ safety valve ทั้งหมดยังเหมือนเดิม เพียงเพิ่มจำนวน candidates
เป้าหมายคือ ถ้าสนับสนุน candidate มากกว่าเดิม 5 เท่า จะเห็นความแข็งแกร่ง/อ่อนแอของ momentum อย่างชัดเจน ใน 39 หุ้น จะมีหุ้นที่ไม่แข็งแรงจริงแต่รอดในลำดับสูงด้วยการตัดสินใจเชิงลบออกง่าย การเพิ่มจำนวนประชากรจะช่วยให้คุณภาพของหุ้นในลำดับสูงดีขึ้น
ผลลัพธ์เป็นอย่างนี้ ตัวเลขทั้งหมดมาจากการวัดจริงของผม ผ่านการทดสอบย้อนหลัง 21 ปี
ผลลัพธ์บนข้อมูลในอดีตไม่ได้รับประกันอนาคต
- ผลตอบแทนต่อปี: 39 หุ้นปัจจุบัน +11.1% → ขยายเป็น 221 หุ้น +18.2%+18.2%
- การลดลงสูงสุดในภาวะล่มสลาย: -25.3% → -31.2%
- ประสิทธิภาพความเสี่ยง (ผลตอบแทน / ความผันผวน): 0.80 →0.96
ผลตอบแทนที่สูงขึ้น 7 จุด และประสิทธิภาพความเสี่ยงดีขึ้น การร่วงลงลึกขึ้นก็จริง แต่ดูเหมือนตัวเลขที่มากกว่าคืนทุนไว้ได้ ทั้งช่วงต้นและช่วงหลังมีการปรับปรุงผลตอบแทน
“นี่คือของจริงใช่ไหม” ในจังหวะนั้น
บอกตามตรง ผมดีใจจนกระโดดสไลด์เลย คือความระมัดระวังที่คงถูกล้มเลิกไปได้ เพราะการทดสอบเดิม ๆ ผมมักพลาดมาในอดีต
แต่ก่อนบันทึกตัวเลข ผมทำขั้นตอนเดิม 1 อย่างอ่านทบทวนบันทึกการตรวจสอบจากตัวเองในอดีตเป็นการเปิดรายงานการตรวจสอบที่เคยทำมาก่อน ตอนนี้เปิดรายงานที่ลองตั้งค่าแบบโจมตีดู แล้วส่วนท้ายมีข้อความอธิบายว่าเมื่อหลายเดือนก่อนผมเขียนไว้ว่า
> ค่าอ้างอิงเมื่อขยายประชากร (ผลตอบแทน +18〜22% / การล่มสลาย -31〜-45%) คือตัวเลขที่คำนวณด้วยโครงสร้างดัชนีหุ้นในปัจจุบัน ที่รวม bias ของการอยู่รอดไว้
ตัวเลขที่ออกมา (+18.2% / -31.2%) ปรากฏอยู่ในช่วงนี้ที่รวม bias ของการอยู่รอดเข้าไปด้วย
ไม่ใช่เรื่องบังเอิญ อย่างที่ผมเคยคิดไว้ว่า “ผลของการขยายประชากร” อาจได้มาจากการแต่งชื่อตลาดให้ดูต่างก็ยังเป็นไปได้ ผมเลยพักเอาไว้ก่อน
bias ของการอยู่รอด คืออะไร?
bias ของการอยู่รอด(seizon-baiasu) = “ดูเฉพาะสิ่งที่รอดชีวิตจนถึงวันนี้ ไม่บันทึกสิ่งที่หายไประหว่างทาง” เป็นคำเรียกอื่นของ bias นี้ด้วย
รายการหุ้น 221 ที่ผมใช้อยู่ ณ ขณะนี้ คือ รายการของบริษัทที่ยังมีการซื้อขายอยู่ในปัจจุบัน ตั้งแต่ปี 2004 ถึง 2026 มีบริษัทที่ล้มละลายหรือถูกควบรวมกิจการหายไปตั้งแต่ตอนแรกก็ไม่ถูกใส่ไว้ในรายการ
ผมได้ตรวจสอบในวันที่ต่างกันอีกวันด้วย ในอุตสาหกรรมเครื่องใช้ไฟฟ้าแบบเดียวกับที่มี 39 หุ้น ในตอนนั้น มีอยู่ 2 บริษัทที่เคยเป็นหุ้นใหญ่แต่ตอนนี้ไม่ได้จดทะเบียนแล้วToshiba(ยุติการจดทะเบียนในธันวาคม 2023) และSanyo Electric(ยุติการจดทะเบียนในมีนาคม 2011) เมื่อผมลองเรียกข้อมูลหุ้นทั้งสองด้วยไลบรารีที่ใช้ดึงข้อมูลจริงๆ ผลลัพธ์ไม่กลับมาแล้วทันทีที่หุ้นจดทะเบียนยุติการจดทะเบียน ความสามารถของระบบข้อมูลที่ผมใช้อยู่ตอนนี้จะทำให้หุ้นนั้นหายไปทั้งหมดนี่คือแก่นแท้ของ bias ของการอยู่รอด
พูดให้ง่ายขึ้น ดังนี้ดูอันดับในปัจจุบันและลองเล่นย้อนกลับดูในอดีตถ้าใช้วิธีรันแบบพบกับทีมที่ชนะเท่านั้น ก็แน่นอนว่าเฉลี่ยผลลัพธ์จะดีกว่า
มีการยืนยันด้วยตัวเลขเช่นกัน ในกองทุนรวมตลาดหุ้นของประเทศไทยที่ถูกเลิกใช้งานช่วงปี 2020-2024 พบว่าอัตราผลตอบแทนเฉลี่ยของปี 2015-2019 อยู่ที่ 5.9% ต่อปี ในขณะที่กองทุนที่ยังดำเนินการอยู่มี 7.4% ต่อปี (อ้างอิง: คอลัมน์ของ Matsui Securities) การไม่ดูค่าที่หายไปทำให้เฉลี่ยดีขึ้นประมาณ 1.5 จุด
การทดสอบเพิ่มเติมชัดเจน: การเบี่ยงเบนในการปรับปรุงเป็นแนวทาง
หลังจากที่หยุดชั่วคราว ผมได้ทำการทดสอบเพิ่มเติมอีกว่า “ถ้า 221 หุ้นอาจจะมากไป เด่นน้อย-มากไปอาจทำให้ bias อยู่ในผลลัพธ์น้อยลง”
การทดสอบที่ 1เลือก 70 หุ้นที่มูลค่าการซื้อขายใน 5 ปีล่าสุดสูงสุดมาเป็นประชากร แล้วผลลัพธ์ใกล้เคียงเดิม อัตราผลตอบแทน +17.6% ความเสี่ยงเทียบเท่า 0.96
แต่รายละเอียดภายในไม่เหมือนกันช่วงแรก (2005-2015) ปรับปรุงได้เพียง +2 จุด ช่วงหลัง (2016-2026) ปรับปรุงได้ +12 จุดช่วงหลังมีผลมากถึง 6 เท่า การเบี่ยงเบนเช่นนี้ดูไม่ธรรมดา
สาเหตุชัดเจนทันที“ช่วง 5 ปีล่าสุดของมูลค่าการซื้อขาย” ที่เราเลือกนั้นซ้ำกับช่วงหลังของการทดสอบ กล่าวคือหุ้นที่ราคาพุ่งสูงในภายหลังแล้วมีการซื้อขายมากขึ้น (เช่น กลุ่มเซมิคอนดักเตอร์) ซึ่งผมที่ทราบผลลัพธ์อยู่แล้วเลือกทีหลังโดยผมที่รู้อยู่แล้วจึงเลือกหุ้นทีหลังก่อนใช้มาตราวัดที่ต่างจากเวอร์ชัน 221 หุ้นเท่านั้น ทำให้การกระทำยังคงเป็น “เลือกจากข้อมูลในอนาคต” เหมือนเดิม
การทดสอบที่ 2ปรับเปลี่ยนมาตราตัดสิน หลักเกณฑ์เลือกจะใช้เฉพาะการซื้อขายในช่วงก่อนที่การทดสอบจะเริ่มต้น 2005-2008 เท่านั้น ตั้งแต่ข้อมูลหลังจากนั้นจะไม่ถูกนำมาใช้ในการเรียงลำดับ
- ผลตอบแทนต่อปี: 39 หุ้น +11.1% → 70 หุ้นใหญ่ (ข้อมูล 2005-2008 เท่านั้น) +11.0%
- การลดลงสูงสุดในภาวะล่มสลาย: -25.3% → -32.3%
ผลปรับปรุงของอัตราผลตอบแทนหายไป การลดลงลึกขึ้นในทุกช่วงยกเลิกการตั้งค่า Bot ไม่มีการเปลี่ยนแปลง
เช็คลิสต์ตรวจสอบสำหรับตัวเองเมื่อผลตัวเลขดีเกินไป
ขอนำเสนอรูปแบบการตรวจสอบที่สร้างขึ้นในครั้งนี้
- ก่อนบันทึกให้ย้อนกลับไปอ่านบันทึกและหมายเหตุของตัวเองในอดีตนี่เป็นความสังเกตแรกของผม ในอดีตที่ผมเตือนว่า “ตัวเลขนี้อธิบาย bias ไว้หมด” ผลลัพธ์ที่ดีมักทำให้ลืมบันทึกไป
- ขอบเขตการปรับปรุงมีความเบี่ยงเบนระหว่างช่วงต้นกับช่วงท้ายหรือไม่หากแท้จริงแล้วควรจะเห็นผลในช่วงเวลาต่างๆ ในรูปแบบที่คล้ายคลึงกัน หากช่วงหนึ่งมีผลมากผิดปกติ ควรสงสัยว่าอาจมีการเลือกคำตอบล่วงหน้าด้วยข้อมูลในช่วงนั้น
- ในการเลือก candidates และการเรียงลำดับ มีข้อมูล “ข้อมูลในปัจจุบัน” หรือ “ข้อมูลช่วงการทดสอบ” ปนอยู่หรือไม่สัดส่วนดัชนีปัจจุบัน ปริมาณการซื้อขายล่าสุด ชุดผู้ชนะล่าสุด ทั้งหมดล้วนทำให้เห็นอนาคตเสมอ ควรจัดอันดับด้วยข้อมูลก่อนช่วงการทดสอบเท่านั้น
เพื่อเป็นแนวทาง อ้างอิงถึงประสบการณ์ของผู้อื่น บทความบล็อกส่วนตัวบางเรื่องกล่าวถึงว่า ในการทดสอบย้อนหลังมีอัตราชนะ 92% และประสิทธิภาพความเสี่ยง 3.5 ซึ่งเกิดจากบั๊กในโค้ดที่ “ซื้อคืนในตอนเช้าหลังจากเห็นราคาลงในวันนี้” (ลุ๊คอเฮดบายอากาศ) ซึ่งเป็นบั๊กในการคาดเดล่วงหน้า วิธีที่พบคือ 1) เปรียบเทียบกับกรณีที่เทรดแบบสุ่ม 2) ตรวจดูธุรกรรมทีละรายการด้วยสายตา 3) ตัดข้อมูลบางช่วงและดูสัญญาณเปลี่ยนไป คำพูดที่ว่า “ตลาดไม่ใจดีขนาดนั้น” ทำให้หายใจไม่ทั่วท้อง (แหล่งที่มา: บล็อก และเทรดอัลกอริทึมส่วนบุคคล)
ข้อเสริม อีกอย่างหนึ่ง คำว่า “การทำให้เหมาะสมมากเกินไป” (overfitting) ไม่ใช่สิ่งเดียวที่ควรระวัง ความจริงคือการปรับ parameters มากเกินไป ในครั้งนี้การเลือกประชากรที่มีผลต่ออนาคตอยู่ในขั้นตอนซึ่งเป็นเรื่องยากในการมองเห็นมากขึ้น
ทำไม “ถ้าเพิ่ม候補 จะดีขึ้น” จึงผิด
เมื่อไม่พลาด bias แล้วประสิทธิภาพกลับลดลง ไม่ใช่เรื่องแค่ไม่ดี แต่การลดลงกลับแย่ลง ด้วย ซึ่งมีเหตุผลด้วย
39 หุ้นในปัจจุบันเป็นรายการที่ทำด้วยมือเพื่อให้ไม่เอียงทางอุตสาหกรรม การเพิ่มเป็น 70 หุ้นโดยใช้แค่ “มาตรวัดเดียวว่าใหญ่และคึกคัก” จะทำให้สัดส่วนธนาคารและอุตสาหกรรมใหญ่ขึ้น เมื่อเกิดวิกฤตทางการเงินปี 2008 ก็จะตกลงมากขึ้นเช่นกัน
คิดว่า “ถ้าเพิ่ม候補 จะช่วยกระจายและเสถียรขึ้น” แต่ถ้ากลไกในการเพิ่มไม่ชัดเจน จะทำให้เกิดการกระจายตัวผิดพลาดเพิ่มจำนวนอย่างไม่ถูกจุดประสงค์จะทำให้เอียง การเพิ่มจำนวนและการรักษาความสมดุลเป็นงานคนละอย่าง
สิ่งที่จะทำต่อไป / สำหรับคนที่กำลังสับสนในจุดเดียวกัน
ครั้งต่อไป หากต้องการขยายประชากรจริงๆ ผมจะเริ่มจากการเตรียม “รายการหุ้นที่ซื้อได้จริง ณ ตอนนั้น” ก่อน ซึ่งเป็นข้อมูล point-in-time เพื่อเก็บบันทึกไว้ ก่อนที่จะปรับประชากรบ่อยๆ เพราะหากไม่ทำเช่นนี้ การทดสอบจะติดกับกรอบนี้ทุกครั้ง
สำหรับผู้ที่ยังสงสัยในจุดนี้เมื่อการทดสอบย้อนหลังให้ผลดี ให้ตั้งคำถามกับตัวเองก่อนโดยเฉพาะเมื่อคุณเพิ่ม候補 แล้วหมุนใช้งาน List ปัจจุบัน ผลลัพธ์ดีๆ อาจมาจากการคาดการณ์อนาคต อย่าลืมว่า “ตัวเลขการทดสอบย้อนหลัง” อาจถูกชะลอหรือถูกแต่งด้วยเครื่องมือบิดเบือน เหมือนกันกับที่เกิดขึ้นในครั้งนี้
ผมเองก็เกือบจะนำมาใช้ด้วยซ้ำ ก่อนที่มั่นใจมากขึ้น บทเรียนที่ช่วยหยุดได้คือข้อความในหมายเหตุที่ผมทิ้งไว้ไม่กี่คำ
※บทความนี้เป็นบันทึกการพัฒนาของผม ไม่แนะนำหุ้นหรือลัทธิการลงทุนใดๆ การลงทุนนั้นขึ้นอยู่กับการตัดสินใจของแต่ละบุคคล