
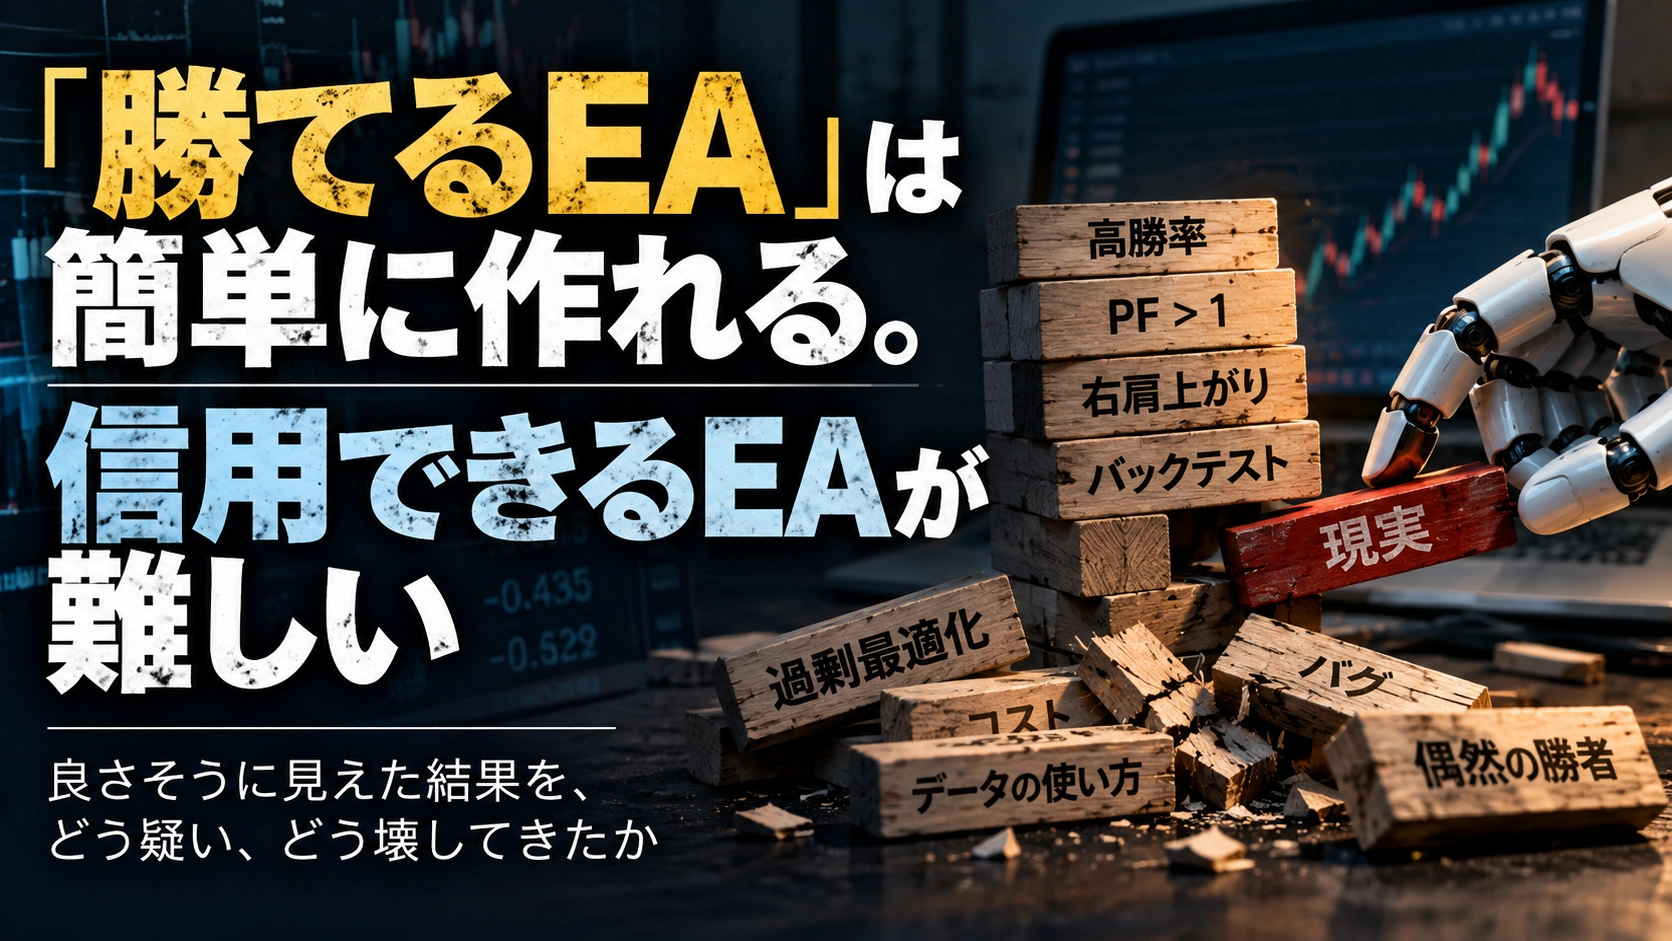
EA ที่ชนะง่ายๆ สามารถสร้างได้ง่ายๆ แต่ EA ที่น่าเชื่อถือยากที่จะหา
# 「勝てるEA」は簡単に作れる。信用できるEAが難しい
ยินดีที่ได้พบคุณ
ขณะสร้างวิธีการซื้อขายอัตโนมัติ เพื่อทดสอบในバック테스트ว่า “ผลลัพธ์ที่ดูดี” สามารถเชื่อถือได้มากน้อยเพียงใด
โดยใช้ AI เพื่อสร้างสมมติฐาน แล้วตรวจสอบด้วยข้อมูลตลาดจริง หากไม่ผ่านก็ทิ้งไป
นี่คือขั้นตอนซ้ำๆ นี้
ในซีรี่ส์นี้ จะไม่ใช่การนำเสนอ “วิธีที่ชนะ” แต่
**ผลลัพธ์ที่ดูดี ควรสงสัยและทำลายมันอย่างไร**
จะเป็นใจกลางของบทความ
ตอนที่ 1 จะเขียนเกี่ยวกับ “กับดักバックテスト” ที่พบจริงในระหว่างการพัฒนาการซื้อขายอัตโนมัติ
---
## ผลバックテストที่ดี สามารถทำได้ง่ายน surprisingly
ช่วงที่เริ่มสร้างการซื้อขายอัตโนมัติ
“PF สูง”
“อัตราการชนะสูง”
“กราฟสินทรัพย์เป็นแนวขึ้นทางด้านขวา”
หากพบตัวเลขแบบนี้ ก็คิดว่าเข้าใ ใกล้จะได้วิธีที่ดี
แต่เมื่อทำการตรวจสอบเพิ่มเติม ความคิดนี้เปลี่ยนไปมาก
ตอนนี้ตรงกันข้ามมากขึ้น
**ยิ่งตัวเลขดีมากเท่าไร ก็ยิ่งสงสัยมากขึ้น**
เพราะ ในバックテスト มีกรณีที่
**สามารถได้ตัวเลขดีๆ แม้ไม่สามารถทำนายแนวตลาดได้**
ดังนั้น
**PF>1 = มีความได้เปรียบในการเข้าเทรด**
ไม่ใช่ว่าจะเป็นจริงเสมอไป
นี่เป็นจุดเปลี่ยนที่สำคัญมาก
---
## เลือกส่วนหน้า แล้วไม่เลือกในภายหลัง
อีกสิ่งที่เปลี่ยนไปคือ วิธีการใช้ข้อมูล
เช่น หากมีข้อมูล 10 ปี
ดูตลอดช่วง 10 ปี
เลือกว่า “TP นี้ดี”
“SL นี้ดี”
“ระยะเวลาการถือครองนี้ดี”
และเลือกไปเรื่อยๆ
สุดท้ายให้ผลลัพธ์ที่ดีที่สุดออกมาในรูปแบบ “手法ที่มีกำไรใน 10 ปี”
นี่เป็นวิธีที่อันตรายมาก
แม้จะดูเหมือนตรวจสอบ 10 ปีแล้วจริง
แต่ด้วยความจริงแล้ว กำลังถูกปรับให้เหมาะสมในช่วง 10 ปี
ดังนั้น
**前半を探索用、後半を確認用**
แบ่งออกเป็นส่วน
การเลือกเงื่อนไขออกมาในช่วงแรก เพื่อให้สำเร็จ
ในช่วงหลัง ให้ดูต่อไปว่า
---
## ก่อนหน้านี้ เลือก แล้วไม่เลือกทบทวนในช่วงหลัง
อีกสิ่งที่เปลี่ยนแปลงใหญ่คือ วิธีการใช้ข้อมูล
ยกตัวอย่าง หากมีข้อมูล 10 ปี
ดูช่วงนี้ทั้งหมด
“TP ดี”
“SL ดี”
“ระยะเวลาการถือครองดี”
เลือกใช้อย่างต่อเนื่อง
สุดท้ายให้ผลลัพธ์ที่ดีที่สุดออกมา
“手法ที่มีกำไรในช่วง 10 ปี”
เสนอตอบ
นี่เป็นอันตรายมาก
ดูเหมือนตรวจสอบ 10 ปีแล้วจริง แต่จริงๆ แล้ว 10 ปีถูกใช้เพื่อทำ optimization
ดังนั้น
**前半を探索用、後半を確認用**
แบ่งไว้ก่อน
การเลือกเงื่อนไขรวมถึงส่วนขยาย จะเสร็จสิ้นในช่วงแรกเท่านั้น
ช่วงหลัง
**ไม่เปลี่ยนแปลงสิ่งที่ตัดสินใจในช่วงแรก แล้วใช้ในการยืนยันต่อไป**
หากเปลี่ยนเงื่อนไขหลังจากช่วงหลัง จะไม่ใช่ข้อมูลยืนยันอีกต่อไป
(出典: `hypothesis_backlog.md:1977-2003, 3016`)
ดูเป็นเรื่องปกติ
แต่พอเริ่มค้นหาปริมาณมาก จะมี誘惑ว่า
“ถ้าปรับเงื่อนไขอีกนิด จะยังคงดูดีอยู่”
อยู่บ่อยๆ
หากใช้ข้อมูลช่วงหลังเรื่อยๆ ก็สามารถสร้างวิธีที่ดีได้เสมอ
---
## หากลองทุกวิธี 17,740 แบบ ก็จะมีผู้ชนะแบบสุ่มด้วย
还有ปัญหาที่ไม่หลีกเลี่ยงได้
**การค้นหาปริมาณมาก**
การตรวจสอบเพียงหนึ่งสมมติฐานแล้วได้ผลดี ก็แตกต่างจากการทดลองเงื่อนไขนับพันๆ หรือหมื่นๆ ข้อที่ได้ผลดีเพียงหนึ่งเดียว
แม้ตัวเลขเดียวกัน ความหมายต่างกัน
ตัวอย่าง แม้จะทอยเหรียญหลายหมื่นครั้ง ถ้าค้นหาวิธีโยนที่ดีที่สุด ก็อาจพบสิ่งที่ดูเหมือนดีมากแบบบังเอิญ
การซื้อขายอัตโนมัตก็เช่นกัน
ในการตรวจสอบจริง ใช้การทดสอบ 17,740 การลองเป็น family เดียว
ด้วยวิธี White Reality Check หรือ Hansen SPA
**“ถึงจะลองเยอะขนาดนี้ แต่ก็ยังมีความหมายในทั้งดครัวของครอบครัวหรือไม่”**
การตรวจสอบด้วยวิธีนี้
stationary bootstrap เป็น 5,000 รอบ
(出典: `item6_white_rc_hansen_spa.py:1-19`)
การดูผลバックテสต์แต่ละรายการไม่เพียงพอ
**“ผลลัพธ์ที่ดีที่สุดในกลุ่มที่ลงมือทำอย่างมาก”**
จะไม่ถูกแยกออกจาก “ความเหนือกว่าแท้จริง”
---
## แม้จะชนะด้วยอัตราชนะ 99.5% ก็ทิ้งไป
ระหว่างการตรวจสอบ
**อัตราชนะ 99.5%**
ดูน่าดึงดูดมาก
แต่เมื่อตรวจสอบภายใน
TP ใกล้กันมาก
SL ไกลมาก
ทำกำไรเล็กๆ หลายครั้ง และแพ้ใหญ่บ้างนานๆ
ยังมีความผิดปกติอื่นๆ ปะปนอยู่ด้วย
ตามแบบตรงๆ ผ่านเกณฑ์ แต่ตรงกับรูปแบบเสื่อมที่ตรวจพบก่อนหน้านี้ จึงไม่ถูกนำมาใช้
(出典: `hypothesis_backlog.md:2320-2331, 2366-2367`)
เรื่องนี้จะยาวมาก จึงจะเขียนละเอียดในบทความอื่น
สิ่งสำคัญคือ
**ไม่ใช่เพราะอัตราชนะสูงแล้วจึงทิ้ง**
“ทำไมถึงได้ 99.5%” จึงตรวจสอบ แล้วไม่สามารถเชื่อสิ่งนั้นได้
จึงทิ้งไป
---
## ปรากฏการณ์ที่เขียนในงานวิจัย อาจไม่สามารถนำไปใช้งานซื้อขายได้ตรงๆ
มีการนำสมมติฐานจากงานวิจัยมาทดสอบด้วย
เกี่ยวกับปรากฏการณ์การเปลี่ยนทิศทางระยะสั้นของ FX บางอัน
ในระยะเวลาที่คล้ายกับบทความเดิม ปรากฏว่า
ในระยะเวลานั้นๆ ผลทางสถิติยังปรากฏอยู่
แต่เมื่อดูตามยุคสมัย ปรากฏว่าลดทอนลง
ในปี 2000-2013 ผลยังชัดเจน แต่หลังจากนั้นลดลง
ในปี 2020-2025 เกือบหายไป
ยิ่งกว่า ปรากฏการณ์ที่รุนแรงในช่วงเวลาหนึ่ง ก็ประมาณการการกลับหน้า 0.15–0.3 pip
สเปรดที่วัดได้อยู่ราว 0.2–1.0 pip
กล่าวคือ
**ปรากฏการณ์ทางสถิติยังมีอยู่**
แต่ไม่ถึงกับใหญ่กว่าค่าค่าคอมมิชชั่นการค้า
สรุปคือ
(出典: `hypothesis_ledger.md:205-219`
`design_A1_vol_regime_reversal_20260902.md:390`)
สิ่งที่เรียนรู้ได้คือ
**“ปรากฏการณ์ในงานวิจัยสามารถทำซ้ำได้หรือไม่” กับ “สามารถซื้อขายได้ด้วยเหตุผลนั้นหรือไม่” เป็นเรื่องคนละเรื่อง**
นอกจากนี้
**สิ่งที่เคยมีอยู่แล้ว และยังมีอยู่ในปัจจุบันก็เป็นคนละเรื่องกัน**
---
## ตัวเลขดีๆ บางครั้งหลังจากนั้น วิธีการตรวจสอบก็พังทลาย
สิ่งที่ซับซ้อนก็คือ
ไม่ใช่กลยุทธ์ แต่
**โค้ดการตรวจสอบหรือสมมติฐานที่ผิดพลาด**
เช่น ในช่วงที่ตรวจสอบกฎบังคับให้ปิดสถานะภายในเวลาที่กำหนด
ตำแหน่งที่หมดเวลาจะไม่ถูกปิดด้วยราคาจริง
ผลกระทบคือบันทึกไว้เป็นกำไรขาดทุนเป็นศูนย์
또는 มีกรณีที่ไม่ได้นำสวอปมาใช้
ในการตรวจสอบ GOLD บางกรณี PF 1.157 เมื่อไม่ใส่สวอปจะได้
PF 1.033 เมื่อใส่สวอปเท่ากับมูลค่าปัจจุบัน
PF 0.922 ถ้าสวอปเป็นสองเท่า
(出典: `hypothesis_backlog.md:3231-3325, 3274-3292`)
バックテストเองทำงานปกติ
ไม่มีข้อผิดพลาด
กราฟก็มี
ตัวเลขก็มี
ดังนั้นจึงเป็นสิ่งที่น่ากลัว
**รหัสที่ทำงานได้กับการตรวจสอบที่ถูกต้องไม่เท่ากับความถูกต้องของการตรวจสอบ**
---
## ปัญหาคือ “สมมติฐานผิด” มากกว่า “ระบบที่ตรวจสอบไม่ถูกต้อง”
เมื่อย้อนกลับไปดูโครงสร้างที่บกพร่อง มีจุดร่วมที่คล้ายกัน
ในช่วงที่กำหนดสมมติฐาน แต่ละข้อดูมีเหตุผลที่น่าเชื่อถือ
ปัญหาคือ
**เมื่อกำหนดสมมติฐานแล้ว ไม่มีระบบที่ตรวจสอบว่ามันยังเหมาะสมอยู่ต่อไปหรือไม่**
(出典: `hypothesis_backlog.md:3234-3235`)
ดังนั้นตอนนี้
เมื่อกำหนดเกณฑ์หรือขีดจำกัด
ไม่ใช่แค่ “ทำไมถึงเป็นตัวเลขนี้”
แต่ยังรวมถึง
**“การตัดสินนี้ขึ้นอยู่กับสมมติฐานอะไรบ้าง”**
ให้จดบันทึกไว้ด้วย
การ固定กฎバックテストเป็นเรื่องสำคัญ
แต่
**การ固定กฎที่ผิดเป็นสิ่งที่ไม่ควรทำต่อไป**
ไม่ใช่
---
## ต้องสงสัยกับการตรวจสอบในอดีตด้วย
ไม่ใช่ว่าจะเชื่อมั่นในแผนที่เคยดูแล้วว่า “ดี” ตลอดไป
มีการตรวจสอบในช่วงเวลาต่างๆ ว่าไม่เสื่อมสภาพในช่วงล่าสุด
ในการตรวจสอบหนึ่ง พบว่า กลุ่มล่าสุดมีค่าเฉลี่ยวันต่อวันที่สูงที่สุด, expectancy และ PF ตามที่ระบุสูงสุด
ความแตกต่างระหว่างช่วงล่าสุดกับช่วงเริ่มต้นยังเป็นบวก
แต่ช่วงความเชื่อมั่น Bootstrap ยังกว้าง และสำหรับกลยุทธ์ที่ไม่แน่นอนที่สุด
**p(Δ<0)=0.247**
(出典: `hypothesis_ledger.md:541-553`)
นั่นหมายถึง
“ช่วงหลังดีกว่า จึงมั่นใจ”
ไม่ใช่การยืนยันว่าไม่เสื่อม
**ข้อมูลปัจจุบันยังไม่มีสัญญาณบ่งชี้ถึงความเสื่อม**
เท่านั้น
ความคิดเห็นนี้สำคัญมาก
---
## ทดลองตรวจสอบสมมติฐานเดิมซ้ำสองครั้ง
เมื่อทำการตรวจสอบมากขึ้น ก็พบปัญหาเพิ่มขึ้น
สมมติฐานที่เคยตรวจสอบแล้วถูกเรียกชื่อหรือมุมมองใหม่
“สมมติฐานใหม่” ที่พยายามเลือกอีกครั้ง
ในความเป็นจริง ไม่ได้เข้าสู่การตรวจสอบซ้ำ เนื่องจากค้นพบจากบันทึกก่อนหน้า
แต่
**การพยายามตรวจสอบสมมติฐานเดิมซ้ำหลายครั้งโดยใช้ชื่อที่ต่างกัน ก็เป็นการค้นหาที่ไม่ถูกบันทึกในระหว่างการ探索**
ดังนั้น ตอนนี้จึงมีสมุดบัญชีสมมติฐาน เพื่อดูว่า
- ไอดีเดียวกันมีอยู่หรือไม่
- ไม่มีสิ่งที่ประเมินคล้ายๆ กันหรือไม่
- สถานะในอดีตเป็นอย่างไร
ตรวจสอบได้
(出典: `hypothesis_ledger.md:7-10`)
ปริมาณงานที่เพิ่มขึ้น ทำให้
“อะไรที่ลองแล้ว”
ไม่เพียงพอที่จะดูว่าอะไรสำเร็จ
และ
**“อะไรที่ลองไปแล้วก็ยังมีอยู่”**
ต้องถูกจัดการด้วย
---
## ยังไม่บอกผลการใช้งานจริง
ไม่ว่าจะทำバックテストเข้มขนาดไหน
ท้ายที่สุดแล้ว หากนำไปใช้งานจริงในตลาด ก็อาจต่างกันได้
แค่ดูการค้าจำนวนไม่มากในช่วงเริ่มต้นก็ไม่พอ
“ชนะ”
“แพ้”
“วิธีนี้ใช้งานได้”
ก็อันตราย
ไม่อยากให้ผลการใช้งานระยะสั้นดูดีเกินจริง
จนกว่าจะมีข้อมูลเพียงพอที่จะประเมินได้
---
## ด้วยการตรวจสอบนี้ สิ่งที่เพิ่มขึ้นคือ เหตุผลในการยกเลิก มากกว่าวิธีที่ชนะ
เมื่อเริ่มพัฒนาอัตโนมัติ
หากตรวจสอบต่อไป
ก็คิดว่า จะพบเงื่อนไข “ชนะ” มากขึ้น
แต่ในความจริงกลับตรงกันข้าม
สิ่งที่เพิ่มขึ้นคือ
- เหตุผลไม่เชื่อ PF อย่างเดียว
- เหตุผลเปรียบเทียบกับสุ่ม
- เหตุผลในการแยกช่วงหน้า-หลัง
- เหตุผลในการปรับการ探索ที่มากเกินไป
- เหตุผลในการสงสัยการตั้งค่า出口
- เหตุผลในการแยกต้นทุนออกจากกัน
- เหตุผลในการแยกอดีตกับปัจจุบัน
- เหตุผลในการสงสัยโค้ดด้วยตัวเอง
- เหตุผลในการบันทึกประวัติสมมติฐาน
ทั้งหมดนี้
การสร้างバックテストที่ดีเองง่ายกว่าที่คิดมาก
สิ่งที่ยากคือ
**การสร้างเหตุผลเพื่อความน่าเชื่อถือของバックテストนั้นๆ**
ดังนั้นตอนนี้
แทนที่จะคิดว่า
“สร้าง EA ที่ชนะ”
มากกว่า
**“ค้นหา EA ที่ยังคงใช้งานได้แม้จะเสียหายไปบ้าง”**
เป็นความรู้สึกที่ใกล้เคียงกว่า
---
## สิ่งที่ซีรีส์นี้จะเขียนต่อไป
ต่อไปนี้
- สมมติฐานที่ดูดี แต่ถูกทำลายอย่างไร
- เมื่อพานงานวิจัยมาสู่ตลาดจริง จะมีอะไรเกิดขึ้น
- ตอนバックテストมีบั๊กที่เปลี่ยนข้อสรุปได้มากแค่ไหน
- การสร้างและตรวจสอบสมมติฐานด้วย AI และการสนับสนุนการตรวจสอบในการวิจัยได้อย่างไร
- วิธีการตรวจสอบเองถูกตั้งคำถามอย่างไร
และ
- การบันทึกประวัติของสมมติฐาน
จะเขียนต่อไป
ซีรีส์นี้ไม่ใช่การนำเสนอผลลัพธ์ “EA ที่ชนะ”
แต่เป็นการบันทึกว่า
**“สิ่งที่ดูว่าจะชนะ ถูกทิ้งไปอย่างไร”**
จะเป็นประโยชน์ต่อผู้ที่ทำการซื้อขายอัตโนมัติหรือバックテストแบบเดียวกัน
※บทความนี้ไม่ใช่การสนับสนุน EA หรือผลิตภัณฑ์การเงินใดๆ หรือการตัดสินใจซื้อขายโดยเฉพาะ
※บทความนี้เป็นการปรับปรุงและเผยแพร่บทความที่เคยลงใน Note