
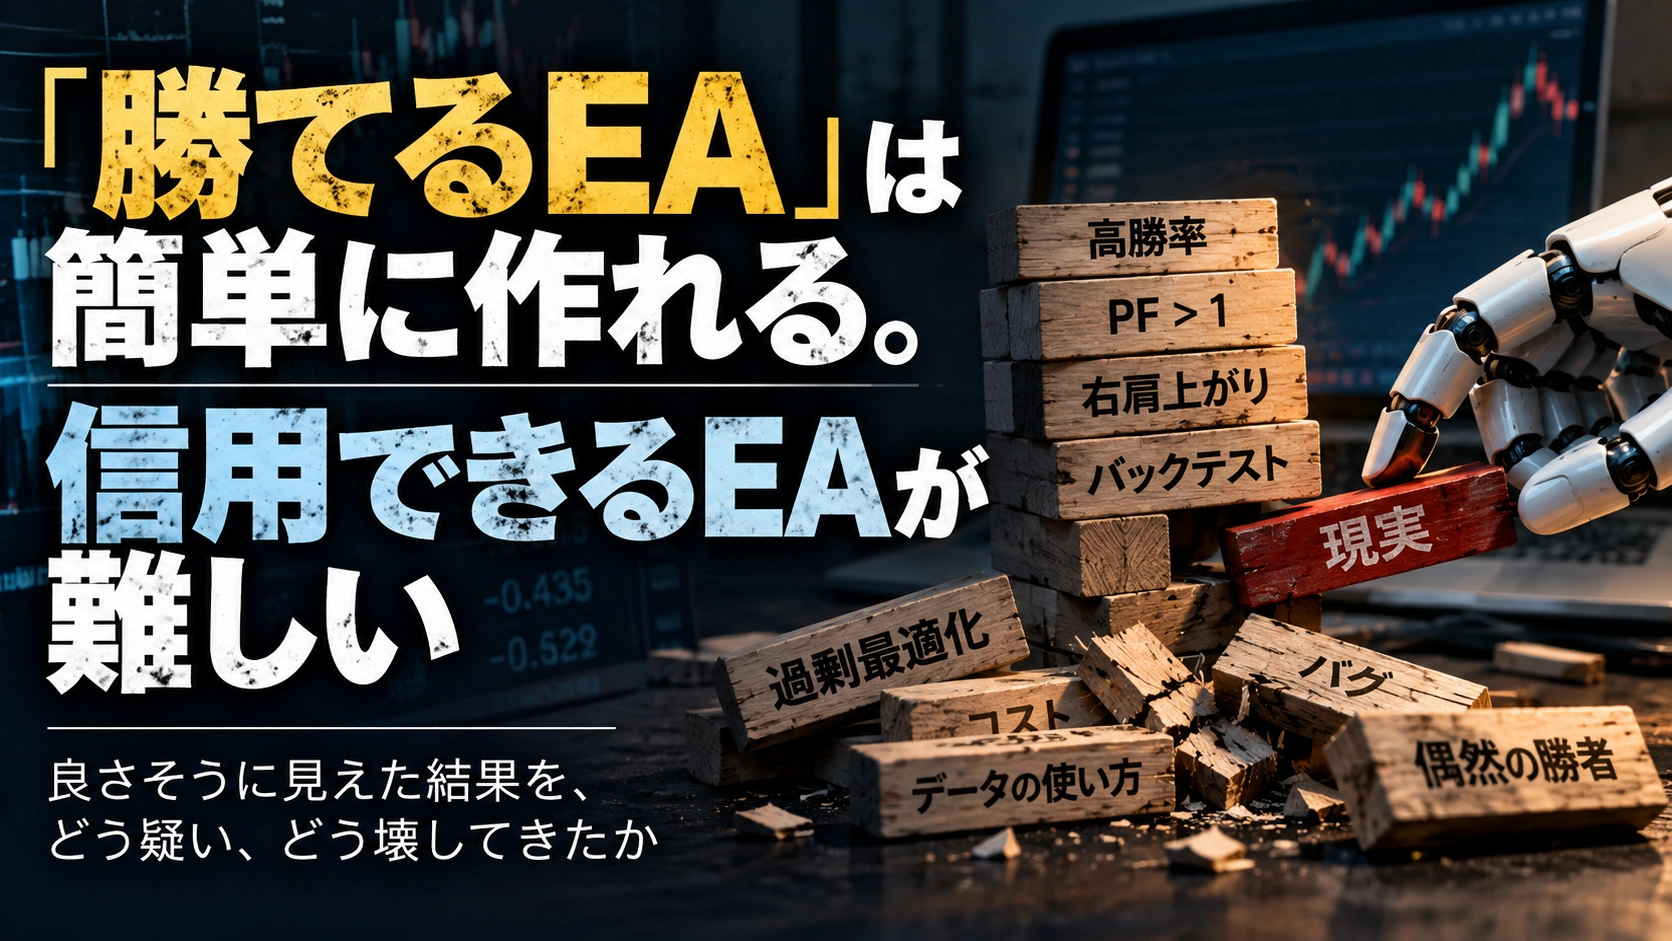
「勝てるEA」は簡単に作れる。信用できるEAが難しい
投資の基礎
# 「勝てるEA」は簡単に作れる。信用できるEAが難しい
はじめまして。
自動売買の手法を作りながら、バックテストで「良く見える結果」をどこまで信用していいのかを検証しています。
AIも使いながら仮説を作り、実際の市場データで検証し、ダメなら捨てる。
この繰り返しです。
この連載では、「勝てた手法」を紹介するというより、
**良さそうに見えた結果を、どう疑い、どう壊してきたか**
を中心に書いていきます。
第1回は、自動売買の開発を続ける中で実際に踏んだ「バックテストの罠」について書きます。
---
## 良いバックテスト結果は、意外と簡単に作れる
自動売買を作り始めた頃は、
「PFが高い」
「勝率が高い」
「右肩上がりの資産曲線になっている」
こういう数字が出れば、良い手法に近づいていると思っていました。
でも検証を続けるうちに、その考えはかなり変わりました。
今はむしろ、
**数字が良いほど、まず疑う**
ようになっています。
なぜなら、バックテストでは、
**相場を予測できていなくても、良い数字が出ることがある**
からです。
---
## PFが1を超えた。それだけでは信用できなかった
PF(Profit Factor)は、
利益の合計 ÷ 損失の合計
で計算されます。
1を超えていれば、少なくともバックテスト上は利益が損失を上回っています。
最初はかなり重視していました。
ところが、大量の出口条件を検証していく中で、おかしなことが起きました。
ある拡張グリッドでは、PF>1.0を通過した1,728セルのうち、
**1,714セル、99.2%**
が、TPとSLの極端な非対称性による数学的なアーティファクトでした。
(出典: `hypothesis_backlog.md:6362-6373`)
方向予測が優れていたわけではありません。
出口の形を極端にするだけで、ランダムに入ってもPFが1を超えやすい領域が存在していた。
つまり、
**PF>1 = エントリーに優位性がある**
ではなかったわけです。
これはかなり大きな転換点でした。
---
## 「ランダムに入るより良いか」を見るようになった
そこで、候補のPFを単独で見るのをやめました。
同じ出口条件でランダムにエントリーした場合のPF分布を作り、
候補がその分布からどのくらい離れているかを見るようにしました。
そこで使ったのがz値です。
当初は、
「候補PFがランダム基準より0.15以上高ければ合格」
という固定幅の基準を使っていました。
ところが調べると、ランダム基準の標準偏差は出口条件によって大きく違っていました。
固定幅では、比較条件によって判定の厳しさが変わってしまいます。
そこで、
**候補がランダム分布から標準偏差何個分離れているか**
を見る方式に変更しました。
(出典: `hypothesis_backlog.md:650-655`)
その結果、ある471件の候補は、
**471件 → 14件**
まで減りました。
(出典: `hypothesis_backlog.md:657-664`)
同じバックテスト結果でも、
「利益が出ているか」
ではなく、
**「ランダムでも同じくらい出るのではないか」**
と聞くだけで、見える景色が変わりました。
---
## 前半で選び、後半では選び直さない
もう1つ大きく変えたのが、データの使い方です。
例えば10年分のデータがあるとして、
その10年間を全部見ながら、
「このTPがいい」
「こっちのSLがいい」
「保有時間はこれがいい」
と選び続ける。
最後に一番良かったものを、
「10年間で利益が出た手法」
として出す。
これはかなり危険です。
10年間を検証したように見えて、実際には10年間を使って最適化しているからです。
そこで、
**前半を探索用、後半を確認用**
に分けました。
出口条件を含めた選択は前半だけで完結させる。
後半では、
**前半で決めたものを変更せず、そのまま確認する。**
後半を見てから条件を変えたら、その後半はもう確認用データではありません。
(出典: `hypothesis_backlog.md:1977-2003, 3016`)
当たり前の話に見えます。
でも実際に大量探索を始めると、
「あと少しだけ条件を変えれば残りそう」
という誘惑が何度も出てきます。
そのたびに後半データを使えば、いくらでも「良い手法」を作れてしまいます。
---
## 17,740通り試せば、偶然の勝者も出てくる
もう1つ避けられない問題があります。
**大量探索です。**
1つの仮説だけを検証して良い結果が出た場合と、
何千、何万という条件を試して、その中の1つだけが良かった場合。
同じ数字でも意味は違います。
例えばコイン投げでも、何万回も「一番成績の良い投げ方」を探せば、偶然とんでもなく良いものが出てきます。
自動売買も同じです。
実際の検証では、17,740試行を1つのfamilyとして扱い、
White Reality CheckやHansen SPAという方法で、
**「これだけ大量に試したことを考慮しても、family全体として意味があるのか」**
を見る検証も行いました。
stationary bootstrapは5,000回です。
(出典: `item6_white_rc_hansen_spa.py:1-19`)
個々のバックテスト結果を見るだけでは、
**「大量に試した中で偶然一番良かったもの」**
を、本物の優位性と区別できません。
---
## 勝率99.5%でも捨てた
検証の途中で、
**勝率99.5%**
という設定も出ました。
普通ならかなり魅力的に見えます。
でも中身を調べると、
TPは極端に近く、
SLは極端に遠い。
小さな利益を何度も確定して、
ごくたまに大きく負ける構造でした。
さらに別の異常も重なっていました。
形式上は基準を通っていましたが、既に確認していた劣化パターンと一致したため、最終的には採用しませんでした。
(出典: `hypothesis_backlog.md:2320-2331, 2366-2367`)
この話は長くなるので、別の記事で詳しく書きます。
大事なのは、
**勝率が高いから捨てたのではない**
ということです。
「なぜ99.5%になったのか」を調べた結果、その数字を信用できなかった。
だから捨てました。
---
## 論文に書いてある現象でも、そのまま売買できるとは限らない
学術論文から仮説を持ってきて検証したこともあります。
あるFXの短期反転現象について、元論文に近い形を調べると、
古い期間では統計的な現象そのものは確認できました。
ところが時代別に見ると、大きく減衰していました。
2000〜2013年には明確だった効果が、
2013年以降は縮小し、
2020〜2025年ではほぼ消えていました。
さらに、現象が強かった時代でさえ、予測される反転幅はおよそ0.15〜0.3pip程度。
実測したスプレッドは0.2〜1.0pip程度でした。
つまり、
**統計的な現象は存在していた。
でも、取引コストを超える大きさではなかった。**
という結論でした。
(出典: `hypothesis_ledger.md:205-219`
`design_A1_vol_regime_reversal_20260902.md:390`)
ここで学んだのは、
**「論文の現象が再現できるか」と「それで売買できるか」は別問題**
だということです。
そして、
**昔存在したことと、現在も存在することも別**
です。
---
## 良い数字が出たあとに、検証方法そのものが壊れていたこともある
もっと厄介なのが、
戦略ではなく、
**検証コードや前提そのものが間違っていたケース**
です。
例えば、一定時間で強制決済するルールを検証していた時期に、
時間切れになったポジションを実際の価格で決済せず、
損益ゼロとして扱っていたことがありました。
また、スワップをモデルに入れていなかったケースもありました。
GOLDのある検証では、
スワップを入れない状態でPF 1.157だったものが、
現在値相当のスワップを入れるとPF 1.033、
2倍のスワップを想定するとPF 0.922まで低下しました。
(出典: `hypothesis_backlog.md:3231-3325, 3274-3292`)
バックテストそのものは正常に動いていました。
エラーも出ません。
グラフも出ます。
数字も出ます。
だから怖い。
**コードが動くことと、検証が正しいことは別です。**
---
## 問題は「間違った前提」より、「前提を再確認する仕組みがなかったこと」
いくつかの構造的な欠陥を振り返ると、共通点がありました。
その前提を決めた時点では、
どれもそれなりに合理的に見えていたことです。
問題は、
**一度決めた前提が、その後も妥当なのかを確認する仕組みがなかったこと。**
(出典: `hypothesis_backlog.md:3234-3235`)
そこで今は、
基準や閾値を決めるとき、
「なぜこの数字なのか」
だけでなく、
**「この判断は、どんな前提が成立していることに依存しているのか」**
も残すようにしています。
バックテストのルールを固定することは大事です。
でも、
**間違ったルールを固定し続けること**
とは違います。
---
## 過去の自分の検証も疑う
一度「良かった」と判断した戦略も、そのまま永久に信用するわけではありません。
時代別に分けて、最近の期間で劣化していないかを見る監査も行いました。
ある監査では、対象となった戦略について、直近区間の平均日次損益・expectancy・記述PFはいずれも最も高く、
直近区間と初期区間の差の点推定もすべてプラスでした。
ただしbootstrapの信頼区間は広く、最も不確実な戦略では、
**p(Δ<0)=0.247**
でした。
(出典: `hypothesis_ledger.md:541-553`)
つまり、
「最近の方が良いから安心」
と言い切れるわけでもない。
**今のデータから劣化の兆候は見えない**
というところまでしか言えません。
この違いはかなり重要だと思っています。
---
## 同じ仮説を2回検証しかけた
検証を増やしていくと、別の問題も出ました。
過去に検証済みの仮説を、
名前や切り口を少し変えて、
「新しい仮説」としてもう一度選びかけたことがあります。
実際には以前の記録を検索して途中で気づいたので、再検証には入りませんでした。
でも、
**同じ仮説を名前を変えて何度も試すことも、記録されない大量探索**
です。
そこで現在は仮説台帳を作り、
新しい仮説に着手する前に、
- 同じIDがないか
- 似た推定対象がないか
- 過去にどんなstatusになったか
を確認するようにしています。
(出典: `hypothesis_ledger.md:7-10`)
研究の量が増えるほど、
「何を試すか」
だけではなく、
**「何をもう試したのか」**
を管理する方が重要になってきます。
---
## 実際の運用結果については、まだ語らない
バックテストをいくら厳しくしても、
最後は実際の市場で動かしてみなければ分からないことがあります。
ただ、運用を始めた直後の少ない取引だけを見て、
「勝った」
「負けた」
「この手法は使える」
と評価するのも危険です。
短期間の実績を大きく見せるつもりはありません。
評価できるだけのデータが溜まるまでは、
**評価不能は評価不能**
として扱います。
---
## この検証を通じて増えたのは、「勝てる方法」より「捨てる理由」だった
自動売買を作り始めたときは、
検証を続ければ、
「勝てる条件」がどんどん見つかると思っていました。
実際には逆でした。
増えたのは、
- PFだけでは信用しない理由
- ランダム基準と比べる理由
- 前半と後半を分ける理由
- 大量探索を補正する理由
- 出口設定を疑う理由
- コストを分離して考える理由
- 過去と現在を分ける理由
- コードそのものを疑う理由
- 仮説の履歴を残す理由
でした。
良いバックテストを作ること自体は、思っていたより簡単でした。
難しいのは、
**そのバックテストを信用していい理由を積み上げること**
です。
だから今は、
「勝てるEAを作る」
より、
**「壊しても残るEAを探す」**
という感覚の方が近いです。
---
## このシリーズで書いていくこと
今後も、
- 良さそうだった仮説がどう壊れたか
- 論文を実市場に持ってくると何が起きるか
- バックテストのバグがどれだけ結論を変えるか
- AIを使った仮説生成や検証支援を、どう研究に組み込んでいるか
- 検証方法そのものをどう疑っているか
といった内容を書いていく予定です。
完成した「勝てるEA」を紹介するシリーズではありません。
むしろ、
**勝てそうに見えたものを、どうやって捨てたか**
の記録になると思います。
同じように自動売買やバックテストをしている方に、
何か1つでも検証のヒントになるものがあれば嬉しいです。
※本記事は、特定のEA・金融商品・個別の売買判断を推奨するものではありません。実際に行った検証と、その検証方法について記録したものです。
※本記事はnoteで公開した記事を、一部調整して再掲載しています。
